深度学习总结
本文最后更新于 2026-08-14
深度学习的主线并不复杂:模型通过前向传播得到预测,损失函数衡量误差,反向传播计算梯度,优化器更新参数,验证集帮助判断模型能否泛化。真正容易混乱的,是把激活函数、初始化、归一化、正则化和优化器当成彼此独立的知识点。
本文只整理神经网络的核心原理。具体的张量操作、训练循环和模型保存放在《PyTorch 学习》;传统模型、特征工程和评估体系放在《机器学习总结》。
知识地图
| 阶段 | 核心问题 | 典型方法 |
|---|---|---|
| 表示 | 网络如何表达非线性关系? | 线性层、卷积、注意力、激活函数 |
| 学习目标 | 什么样的预测算“好”? | MSE、交叉熵、任务指标 |
| 求梯度 | 参数应该向哪个方向调整? | 计算图、链式法则、反向传播 |
| 更新参数 | 怎样更快、更稳定地收敛? | SGD、Momentum、AdamW、学习率调度 |
| 稳定训练 | 如何避免梯度消失、爆炸或分布漂移? | 初始化、归一化、残差连接、梯度裁剪 |
| 提升泛化 | 如何减少过拟合? | 数据增强、权重衰减、Dropout、早停 |
一次完整训练可以概括为:
$$
x \xrightarrow{f_\theta} \hat{y}
\xrightarrow{\mathcal{L}(\hat{y}, y)} \text{loss}
\xrightarrow{\nabla_\theta \mathcal{L}} \theta_{t+1}
$$
神经网络如何表示函数
线性层与非线性
全连接层执行仿射变换:
$$
z = Wx + b
$$
如果多层网络之间没有非线性激活函数,那么多次线性变换仍能合并成一次线性变换,增加层数也不会提升模型对复杂关系的表达能力。因此,常见神经网络层通常写成:
$$
h = \phi(Wx+b)
$$
其中 $\phi$ 是激活函数。
激活函数怎么选
| 激活函数 | 输出特点 | 常见位置 | 注意点 |
|---|---|---|---|
| ReLU | 负数变 0,正数保持不变 | CNN、MLP 隐藏层 | 简单高效,但可能出现神经元长期不激活 |
| Leaky ReLU | 负半轴保留小斜率 | ReLU 的替代方案 | 减少“死亡 ReLU”问题 |
| GELU | 平滑地按输入大小进行门控 | Transformer 隐藏层 | 计算比 ReLU 稍复杂 |
| Sigmoid | 映射到 $(0,1)$ | 二分类单输出、门控 | 深层隐藏层中容易饱和并导致梯度变小 |
| Tanh | 映射到 $(-1,1)$ | 部分循环网络与门控 | 零中心,但仍可能饱和 |
| Softmax | 将一组 logits 转成概率分布 | 多分类推理输出 | 训练时通常直接把 logits 交给交叉熵损失 |
Sigmoid 与 ReLU 可以直接写成:
$$
\sigma(x)=\frac{1}{1+e^{-x}},\qquad
\sigma’(x)=\sigma(x)(1-\sigma(x))
$$
$$
\operatorname{ReLU}(x)=\max(0,x),\qquad
\operatorname{ReLU}’(x)=
\begin{cases}
0,&x<0\
1,&x>0
\end{cases}
$$
Sigmoid 的导数最大值只有 $1/4$,输入绝对值较大时梯度会迅速减小;ReLU 在正半轴保持梯度,但 $x=0$ 处不可导,实践中由框架约定一个次梯度。
二分类常用一个 logit 配合 Binary Cross Entropy;多分类输出 $C$ 个 logits,训练时不要为了“看起来像概率”而提前手动 Softmax,避免与损失函数内部计算重复。
网络深度、宽度与残差
- 宽度决定一层能同时表示多少特征。
- 深度让模型逐级组合特征,但也增加优化难度。
- 残差连接把输入直接加到变换结果上:$y=F(x)+x$,为梯度提供更短的传播路径。
深度并非越大越好。数据规模、任务复杂度、计算预算和正则化能力共同决定合适的模型容量。
损失函数定义学习目标
回归任务
均方误差对大误差惩罚更强:
$$
\operatorname{MSE}=\frac{1}{n}\sum_{i=1}^{n}(\hat{y}_i-y_i)^2
$$
平均绝对误差对异常值更稳健:
$$
\operatorname{MAE}=\frac{1}{n}\sum_{i=1}^{n}|\hat{y}_i-y_i|
$$
Smooth L1 在误差较小时使用平方形式、较大时接近绝对值,兼顾平滑梯度和异常值鲁棒性。
分类任务
二元交叉熵:
$$
\mathcal{L}=-\frac{1}{n}\sum_{i=1}^{n}
\left[y_i\log p_i+(1-y_i)\log(1-p_i)\right]
$$
多分类交叉熵:
$$
\mathcal{L}=-\frac{1}{n}\sum_{i=1}^{n}\log p(y_i\mid x_i)
$$
损失函数用于训练,业务指标用于判断模型是否真正有用。类别不平衡时,仅看 Accuracy 可能掩盖少数类表现,需要同时观察 Precision、Recall、F1、PR-AUC 等指标。
反向传播与计算图
链式法则
假设 $z=f(y)$、$y=g(x)$,则:
$$
\frac{\partial z}{\partial x}
=\frac{\partial z}{\partial y}
\frac{\partial y}{\partial x}
$$
神经网络的反向传播就是从损失开始,沿计算图反向应用链式法则,把梯度传到每一层参数。
对于仿射层 $Y=XW+b$,反向传播关注三类梯度:
$$
\frac{\partial \mathcal{L}}{\partial X},\qquad
\frac{\partial \mathcal{L}}{\partial W},\qquad
\frac{\partial \mathcal{L}}{\partial b}
$$
$W$ 和 $b$ 的梯度用于更新当前层参数,$X$ 的梯度继续传给前一层。记上游梯度为 $G_Y=\partial\mathcal{L}/\partial Y$,则:
$$
\frac{\partial\mathcal{L}}{\partial X}=G_YW^T,\qquad
\frac{\partial\mathcal{L}}{\partial W}=X^TG_Y,\qquad
\frac{\partial\mathcal{L}}{\partial b}=\sum_{i=1}^{B}G_{Y,i}
$$
对于 Softmax 与交叉熵的常见组合,设 logits 为 $z$、预测概率为 $p$、one-hot 标签为 $y$,输出层梯度可简化为:
$$
\frac{\partial\mathcal{L}}{\partial z}=p-y
$$
梯度消失与梯度爆炸
深层网络需要连续相乘局部梯度:
- 多个绝对值小于 1 的梯度相乘,可能逐渐趋近 0,形成梯度消失。
- 多个较大的梯度相乘,可能快速增大,形成梯度爆炸。
常见缓解方式包括合适的激活函数与初始化、归一化、残差连接、合理学习率以及梯度裁剪。排查时应先记录梯度范数,而不是盲目更换优化器。
参数如何更新
Epoch、Batch 与 Iteration
- Batch size:一次前向和反向传播使用的样本数。
- Iteration / Step:完成一个 batch 的参数更新。
- Epoch:完整遍历一次训练集。
若训练集有 $N$ 个样本,batch size 为 $B$,则每个 epoch 大约有 $\lceil N/B \rceil$ 个 step。
常见优化器
基础梯度下降更新为:
$$
\theta_{t+1}=\theta_t-\eta\nabla_\theta\mathcal{L}
$$
| 优化器 | 核心特点 | 适合场景 |
|---|---|---|
| SGD | 直接使用当前小批量梯度 | 作为可靠基线,常用于视觉模型 |
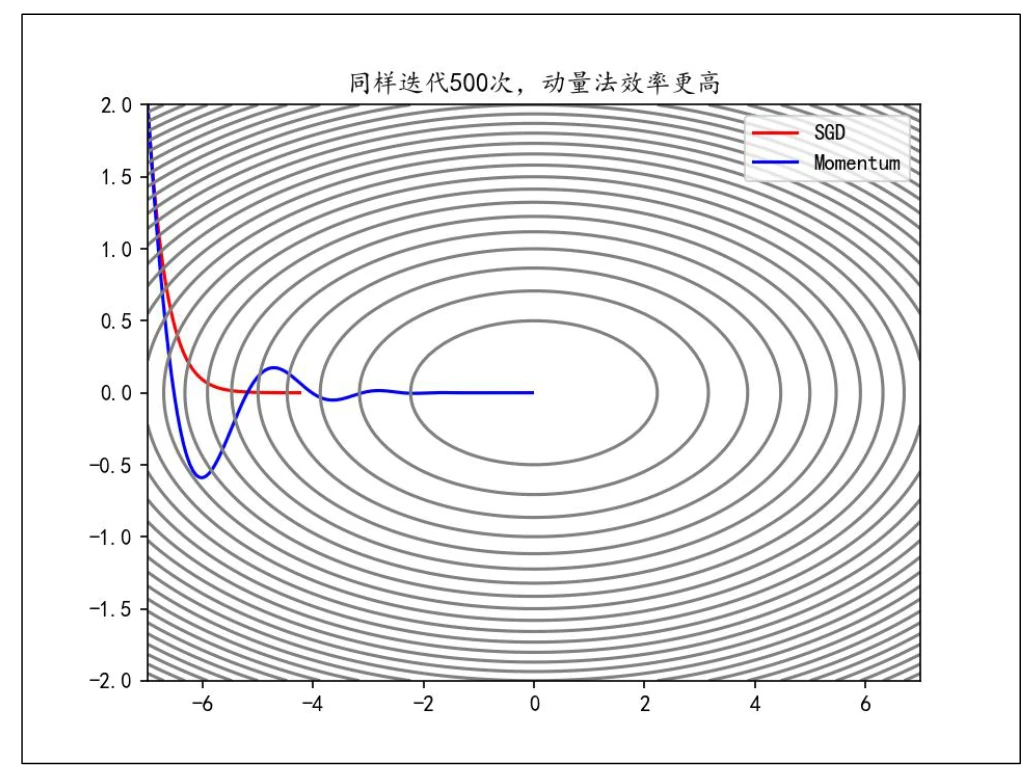
| SGD + Momentum | 累积历史方向,减少震荡 | 希望获得稳定泛化、愿意调学习率 |
| Adam | 为每个参数自适应调整步长 | 快速实验、稀疏梯度 |
| AdamW | 将权重衰减与梯度更新解耦 | Transformer 与大多数现代深度学习任务 |
优化器没有绝对优劣。更重要的是学习率、训练步数、batch size、权重衰减以及是否有合适的 warmup 和衰减策略。
学习率策略
典型过程是训练初期逐渐 warmup,随后按 Step、Cosine 或 Plateau 等策略降低学习率。学习率过大会震荡或发散,过小则收敛缓慢,并可能在有限训练时间内表现为“学不动”。
初始化、归一化与稳定训练
参数初始化
所有神经元使用完全相同的初始权重会破坏对称性,导致它们学习到相同特征。常见初始化方法:
| 方法 | 方差依据 | 常见搭配 |
|---|---|---|
| Xavier / Glorot | 同时考虑 fan_in 和 fan_out |
Tanh、Sigmoid、近似对称激活 |
| He / Kaiming | 主要考虑 fan_in |
ReLU 及其变体 |
以零均值正态初始化为例,Xavier 常取 $\operatorname{Var}(W)=2/(\text{fan_in}+\text{fan_out})$,He 初始化常取 $\operatorname{Var}(W)=2/\text{fan_in}$。框架通常已经为标准层提供合理默认值,除非有明确依据,不需要给所有层手动套同一种初始化。
归一化
| 方法 | 归一化维度 | 常见场景 |
|---|---|---|
| Batch Normalization | 依赖 batch 统计量 | CNN、大 batch 训练 |
| Layer Normalization | 对单个样本的特征归一化 | Transformer、序列模型 |
| RMSNorm | 根据均方根缩放,不减均值 | 大语言模型 |
BatchNorm 先使用当前小批量的均值 $\mu_B$ 和方差 $\sigma_B^2$ 标准化,再通过可学习参数 $\gamma$ 和 $\beta$ 恢复表达能力:
$$
\hat{x}=\frac{x-\mu_B}{\sqrt{\sigma_B^2+\epsilon}},\qquad
y=\gamma\hat{x}+\beta
$$
BatchNorm 在训练和推理时行为不同,因此框架中需要正确切换 train() 与 eval()。LayerNorm 不依赖 batch 统计量,更适合变长序列和小 batch。
梯度裁剪与数值稳定
梯度裁剪通常用于限制梯度范数,缓解偶发的梯度爆炸。混合精度训练还需要关注溢出、损失缩放和不稳定算子。出现 NaN 时,优先检查:
- 输入数据是否包含 NaN 或 Inf。
- 学习率是否过大。
log(0)、除零和指数溢出。- 梯度范数从哪一步开始异常。
泛化与正则化
训练集、验证集和测试集
- 训练集用于更新参数。
- 验证集用于选模型、调超参数和早停。
- 测试集只用于最终评估,不应反复参与调参。
训练损失持续下降、验证损失先降后升,通常是过拟合信号;两者都很高,则更可能是欠拟合、优化失败或数据存在问题。
常用手段
| 方法 | 作用 | 注意点 |
|---|---|---|
| 数据增强 | 扩大有效训练分布 | 增强方式必须符合任务语义 |
| 权重衰减 | 限制参数规模 | AdamW 比把 L2 项直接混入 Adam 更清晰 |
| Dropout | 训练时随机屏蔽部分激活 | 推理前必须切换为评估模式 |
| Early Stopping | 验证指标长期无改善时停止 | 需要保存最佳 checkpoint |
| Label Smoothing | 避免分类模型过度自信 | 过大会损害区分能力 |
正则化不是越多越好。首先排除数据泄漏、标签错误和训练/推理预处理不一致,再调整正则化强度。
卷积神经网络
卷积层
卷积核在局部区域共享参数,适合提取具有空间结构的特征。二维卷积输出尺寸为:
$$
H_{out}=\left\lfloor\frac{H_{in}+2P-D(K-1)-1}{S}+1\right\rfloor
$$
其中 $K$ 为卷积核尺寸、$S$ 为步幅、$P$ 为填充、$D$ 为膨胀率。
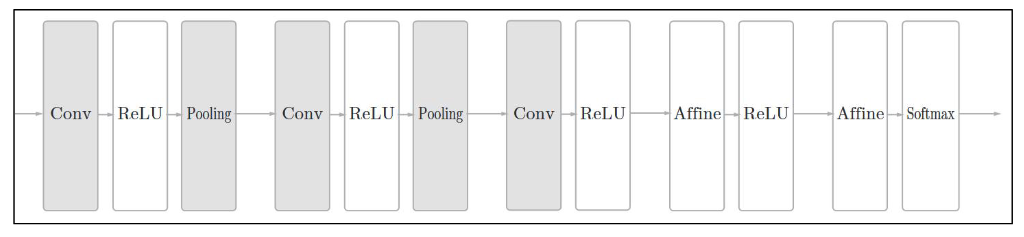
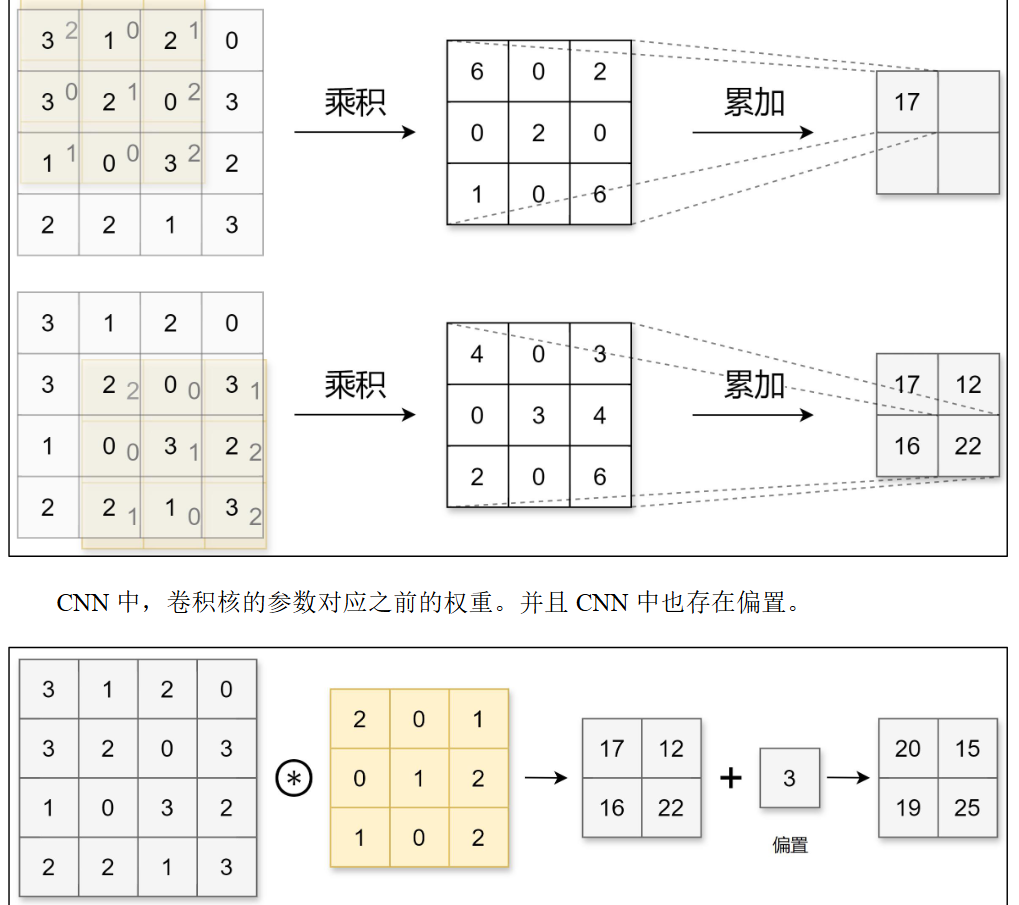
- Padding 控制边缘信息和输出尺寸。
- Stride 控制下采样速度。
- Dilation 在不显著增加参数的情况下扩大感受野。
池化与下采样
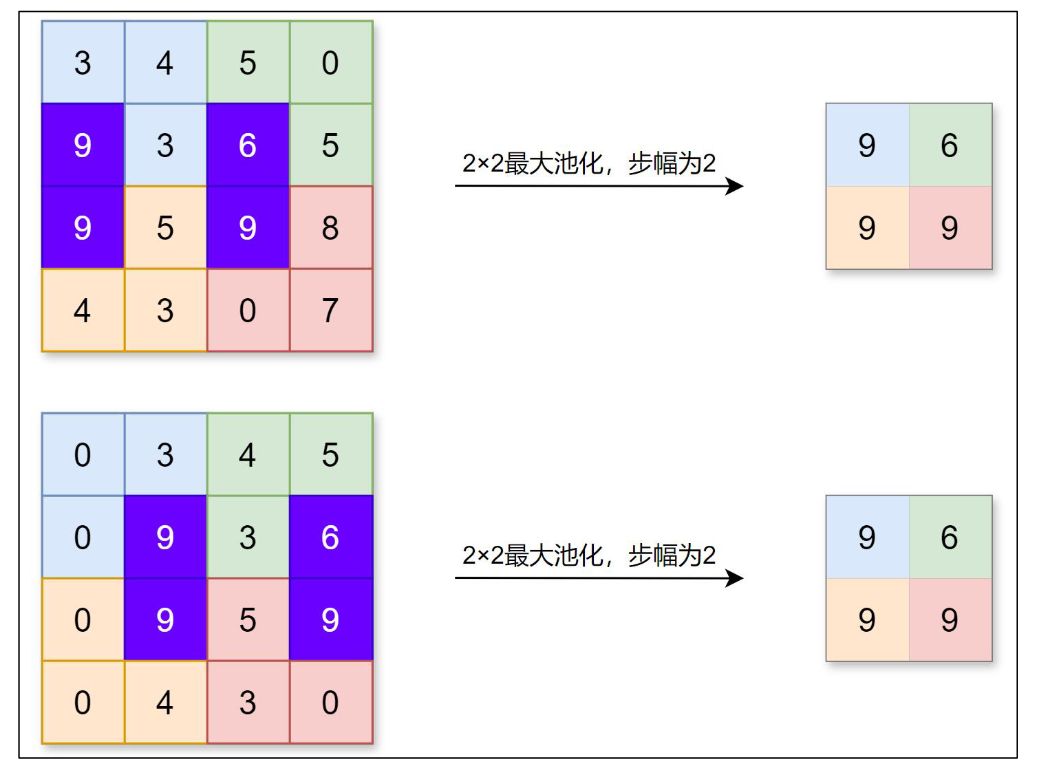
最大池化保留局部强响应,平均池化保留平均趋势。现代网络也常使用带步幅的卷积完成下采样。池化能降低特征图尺寸,但过度下采样会损失细节。
CNN 与 Transformer 的边界
CNN 依赖局部连接和参数共享,具有较强的空间归纳偏置;Transformer 通过注意力直接建模远距离关系。二者并非互斥,现代视觉和多模态模型经常组合使用。Transformer、注意力和大模型训练细节见《LLM 知识梳理》;本文不再重复展开。
训练问题排查表
| 现象 | 优先检查 | 常见处理 |
|---|---|---|
| loss 完全不下降 | 标签、数据尺度、梯度、学习率 | 先让模型过拟合一个很小的数据集 |
| 训练正常但验证很差 | 数据泄漏、分布差异、过拟合 | 检查划分方式并加强有效正则化 |
| loss 突然变成 NaN | 输入异常、学习率、数值溢出 | 记录中间值与梯度范数,降低学习率 |
| 指标与 loss 方向不一致 | 指标实现、阈值、类别不平衡 | 查看混淆矩阵和分组指标 |
| 推理结果每次不同 | 未切换评估模式、随机预处理 | 调用 eval() 并固定推理流程 |
| GPU 利用率低 | 数据加载、batch 太小、频繁同步 | 分析数据管线和算子耗时 |
