机器学习总结
本文最后更新于 2026-08-14
机器学习不是“选择一个算法然后训练”,而是一套围绕数据、目标和评估展开的实验流程。模型只负责从输入到输出的映射,真正决定结果是否可信的,还包括数据划分、特征处理、指标、验证方式和上线后的分布变化。
本文整理传统机器学习与通用评估方法。神经网络原理见《深度学习总结》,框架实现见《PyTorch 学习》。
知识地图
机器学习方法可以概括为:
$$
\text{机器学习方法}=\text{模型}+\text{策略}+\text{算法}
$$
| 组成 | 回答的问题 | 示例 |
|---|---|---|
| 模型 | 学习什么形式的映射? | 线性模型、树模型、神经网络 |
| 策略 | 什么样的模型算好? | 均方误差、对数损失、最大间隔 |
| 算法 | 怎样找到合适的参数? | 梯度下降、坐标下降、树的递归划分 |
一个完整项目通常经过:
$$
\text{定义问题}\rightarrow\text{准备数据}\rightarrow\text{建立基线}
\rightarrow\text{训练验证}\rightarrow\text{误差分析}\rightarrow\text{上线监控}
$$
问题类型
| 类型 | 数据特点 | 典型任务 |
|---|---|---|
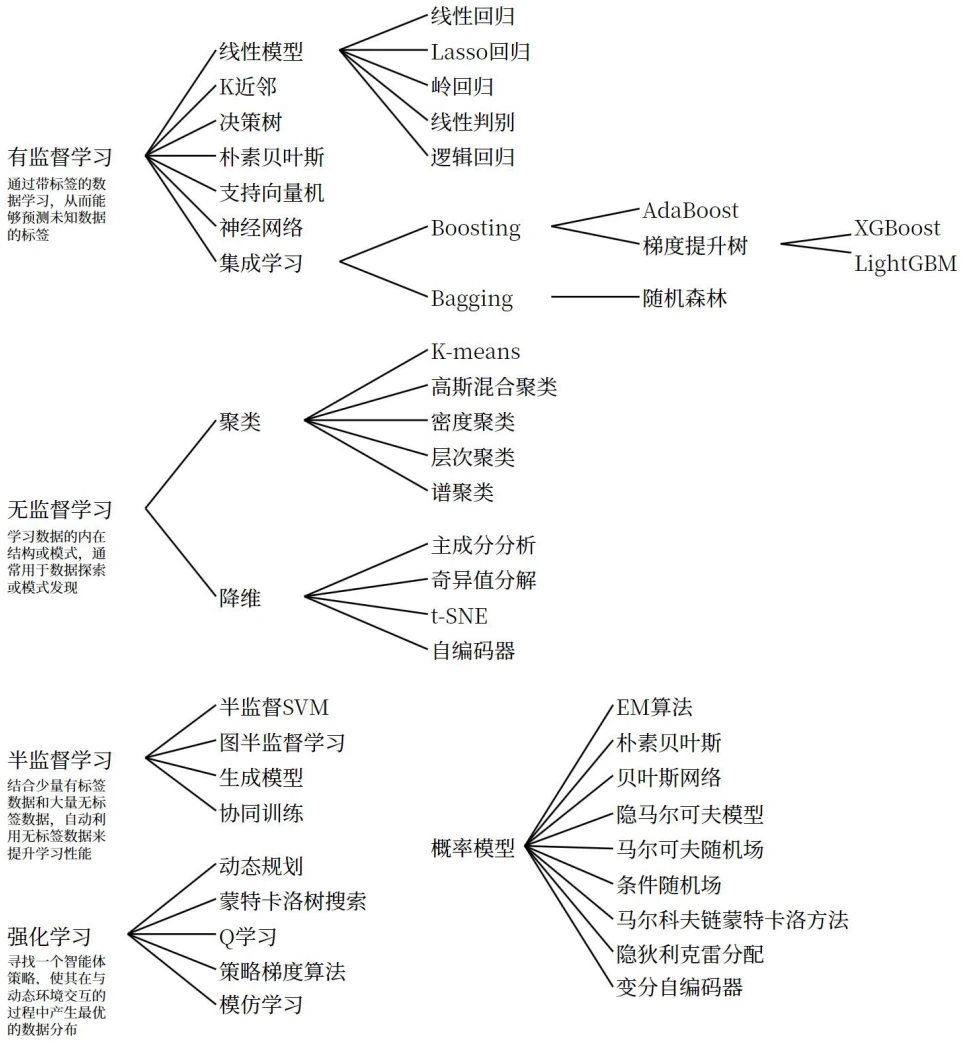
| 监督学习 | 样本带目标标签 | 分类、回归、排序 |
| 无监督学习 | 没有目标标签 | 聚类、降维、异常检测 |
| 半监督学习 | 少量有标签、大量无标签 | 标注成本高的分类任务 |
| 自监督学习 | 从数据本身构造学习信号 | 表示学习、预训练 |
| 强化学习 | 智能体通过交互获得奖励 | 控制、决策、策略优化 |
开始建模前,先把业务问题改写成可评估的统计问题:预测对象是什么、预测发生在什么时间、可用特征有哪些、错误代价是否对称、模型结果如何被使用。
数据划分与泄漏
训练集、验证集和测试集
- 训练集用于拟合参数。
- 验证集用于选择特征、模型和超参数。
- 测试集用于最终一次评估。
如果在测试集上反复比较模型,测试集事实上已经参与了调参,最终结果会过于乐观。
随机划分、分层划分与时间划分
| 数据特点 | 推荐划分 |
|---|---|
| 独立同分布、类别较均衡 | 随机划分 |
| 分类且类别比例差异明显 | 分层划分,保持各集合类别比例 |
| 时间序列或有明确先后关系 | 按时间向前验证,不能随机打乱未来信息 |
| 同一用户/设备有多条记录 | 按实体分组,避免同一实体跨集合泄漏 |
常见数据泄漏
数据泄漏是指训练时使用了真实预测时刻无法获得的信息。常见来源:
- 在全量数据上先做标准化、缺失值填充或特征选择,再划分数据。
- 将标签的直接结果或事后信息作为输入特征。
- 同一用户、病人、设备或重复样本同时出现在训练集和测试集。
- 时间任务中使用未来统计量预测过去。
所有需要“学习数据统计量”的预处理步骤都应只在训练集上 fit,再对验证集和测试集 transform。使用 Pipeline 可以显著降低泄漏风险。
特征工程
缺失值与异常值
- 数值特征可以使用中位数、分组统计或模型预测填充。
- 类别特征可以增加“未知”类别。
- 缺失本身可能包含信息,可以增加缺失指示变量。
- 异常值先确认是业务真实极端情况还是采集错误,再决定截断、变换或保留。
不存在对所有数据都正确的填充方式。预处理方法必须进入交叉验证流程,而不是预先在全量数据上确定。
数值特征变换
Min-Max 归一化:
$$
x’=\frac{x-x_{min}}{x_{max}-x_{min}}
$$
标准化:
$$
x’=\frac{x-\mu}{\sigma}
$$
标准化对线性模型、KNN、SVM 和依赖梯度的模型通常很重要;树模型根据阈值划分,对单调尺度变化通常不敏感。
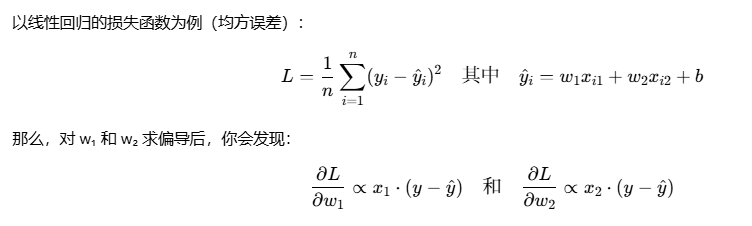
长尾正值数据可考虑 log1p;存在负值时可考虑 Yeo-Johnson 等变换。变换的目标是改善分布和优化条件,而不是机械地让每个特征“看起来像正态分布”。
类别变量编码
| 方法 | 适合场景 | 风险 |
|---|---|---|
| One-Hot | 低基数、无序类别 | 高基数时维度膨胀 |
| Ordinal Encoding | 有明确顺序的类别 | 无序类别会引入虚假大小关系 |
| Frequency Encoding | 高基数类别 | 可能丢失类别语义 |
| Target Encoding | 高基数且与目标相关 | 极易泄漏,必须在折内计算并平滑 |
特征选择与降维
- Filter:根据相关性、互信息、方差等独立筛选。
- Wrapper:用模型表现评估特征子集,例如递归特征消除。
- Embedded:在训练中完成选择,例如 L1 正则化、树模型重要性。
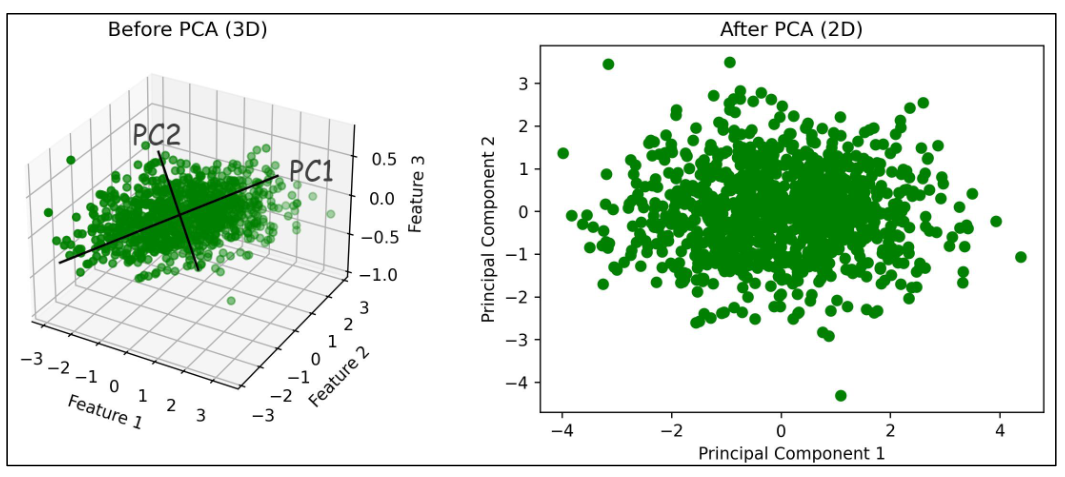
- PCA:把相关特征投影到新的正交方向,适合压缩与去相关,但可解释性会降低。
树模型的内置重要性可能偏向连续或高基数特征。需要解释模型时,可以结合 permutation importance、SHAP 和业务稳定性验证。
分类模型评估
混淆矩阵
| 真实 / 预测 | 正类 | 负类 |
|---|---|---|
| 正类 | TP | FN |
| 负类 | FP | TN |
准确率:
$$
Accuracy=\frac{TP+TN}{TP+TN+FP+FN}
$$
精确率表示“预测为正的样本中有多少是真的”:
$$
Precision=\frac{TP}{TP+FP}
$$
召回率表示“真实正类中有多少被找出”:
$$
Recall=TPR=\frac{TP}{TP+FN}
$$
F1 是 Precision 与 Recall 的调和平均:
$$
F1=2\cdot\frac{Precision\cdot Recall}{Precision+Recall}
$$
假阳性率:
$$
FPR=\frac{FP}{FP+TN}
$$
注意分母:TPR 面向所有真实正类,FPR 面向所有真实负类。
指标怎么选
| 业务重点 | 优先指标 | 示例 |
|---|---|---|
| 总体分类是否正确且类别均衡 | Accuracy | 普通多分类 |
| 误报成本高 | Precision | 垃圾内容误杀、营销触达 |
| 漏报成本高 | Recall | 疾病筛查、欺诈初筛 |
| 同时关注误报和漏报 | F1 / F-beta | 信息抽取、搜索召回 |
| 比较不同阈值下的排序能力 | ROC-AUC、PR-AUC | 风险评分、二分类排序 |
| 预测概率要可信 | Log Loss、Brier Score、校准曲线 | 风险概率、转化概率 |
类别极不平衡时,PR-AUC 往往比 ROC-AUC 更直观。AUC 衡量排序能力,不代表选定阈值后的业务收益;最终阈值应结合误报与漏报成本确定。
多分类平均方式
- Macro:每个类别先独立计算再平均,平等对待少数类。
- Micro:汇总所有样本的 TP、FP、FN 后计算,更受大类影响。
- Weighted:按各类别样本数加权平均。
报告多分类结果时,应同时给出混淆矩阵和每类指标,避免一个平均值掩盖关键类别问题。
回归模型评估
平均绝对误差:
$$
MAE=\frac{1}{n}\sum_{i=1}^{n}|\hat{y}_i-y_i|
$$
均方误差与均方根误差:
$$
MSE=\frac{1}{n}\sum_{i=1}^{n}(\hat{y}_i-y_i)^2
$$
$$
RMSE=\sqrt{MSE}
$$
决定系数:
$$
R^2=1-\frac{\sum_i(y_i-\hat{y}_i)^2}{\sum_i(y_i-\bar{y})^2}
$$
| 指标 | 优点 | 注意点 |
|---|---|---|
| MAE | 与目标同单位,对异常值较稳健 | 梯度在 0 处不光滑 |
| RMSE | 与目标同单位,更重视大误差 | 易被异常值主导 |
| $R^2$ | 相对均值基线衡量解释能力 | 测试集上可能小于 0 |
| MAPE | 相对误差直观 | 真实值接近 0 时不稳定 |
除了平均指标,还应查看残差随时间、目标大小和关键人群的分布。平均误差正常,不代表每个分组都可靠。
交叉验证与模型选择
常见验证方式
| 方法 | 适用情况 | 说明 |
|---|---|---|
| Hold-out | 数据量充足、快速基线 | 一次划分,结果受随机性影响 |
| K-Fold | 常规中小数据集 | 轮流使用一折验证 |
| Stratified K-Fold | 分类且类别不平衡 | 每折保持大致类别比例 |
| Group K-Fold | 同一实体多条记录 | 同一组不会跨训练与验证 |
| Time Series Split | 时间序列 | 训练只使用验证时间之前的数据 |
超参数搜索必须嵌套在训练数据内部。如果先看测试集结果再继续调参,就已经污染测试集。
偏差与方差
- 高偏差:训练和验证表现都差,模型可能欠拟合。
- 高方差:训练很好、验证明显较差,模型可能过拟合。
应对高偏差可以增加有效特征、提升模型容量或改善优化;应对高方差可以增加数据、简化模型、加强正则化或提高验证可靠性。
监督学习经典模型
线性回归
线性回归假设目标是特征的线性组合:
$$
\hat{y}=w^Tx+b
$$
它训练快、可解释性强,是回归任务的重要基线。需要关注特征尺度、多重共线性、异常值以及残差模式。
逻辑回归
逻辑回归对线性组合应用 Sigmoid,得到二分类概率:
$$
p(y=1\mid x)=\frac{1}{1+e^{-(w^Tx+b)}}
$$
它仍然是线性决策边界,但可以通过特征交叉和非线性变换增强表达能力。多分类可以使用 One-vs-Rest 或 Softmax 回归。
决策树与集成学习
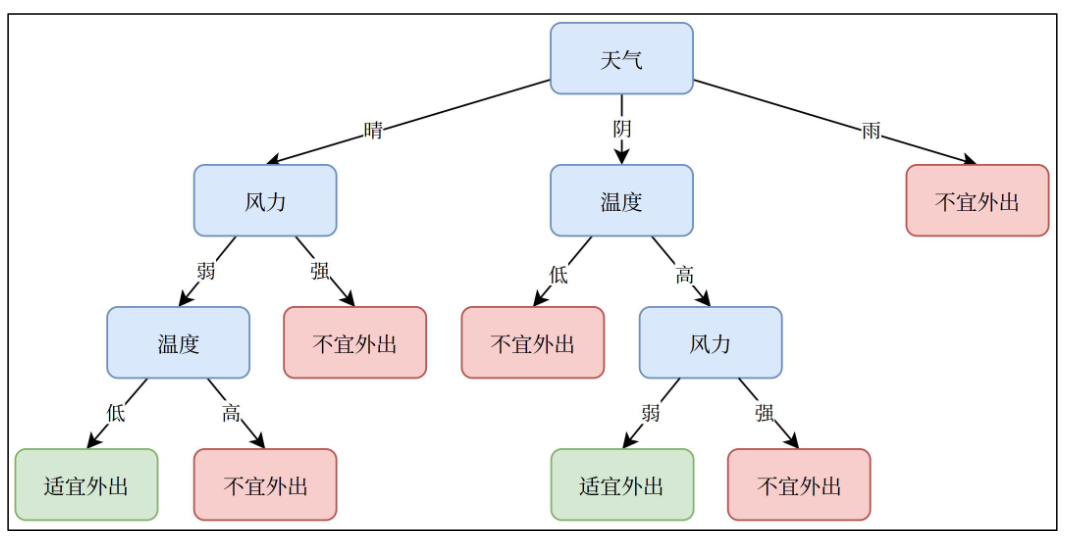
决策树递归选择特征和阈值划分数据。分类树常用 Gini 或信息增益,回归树常用平方误差。单棵树容易过拟合,需要限制深度、叶子样本数或进行剪枝。
| 模型 | 组合方式 | 特点 |
|---|---|---|
| Random Forest | 对不同样本和特征训练多棵树后平均 | 稳健、并行、调参相对简单 |
| Gradient Boosting | 后一棵树拟合前面模型的误差 | 精度高,但需要控制学习率和树复杂度 |
| XGBoost / LightGBM | 工程化梯度提升树 | 表格数据常用,支持正则化和高效训练 |
SVM、KNN 与朴素贝叶斯
- SVM:通过最大化分类间隔获得决策边界,核函数可以表达非线性;对特征尺度敏感。
- KNN:根据邻近样本投票或平均,没有显式训练过程;推理成本随数据量增加。
- 朴素贝叶斯:假设给定类别后特征条件独立,训练快,在文本分类等稀疏任务中仍是有效基线。
如何建立算法基线
| 数据与目标 | 可先尝试的模型 |
|---|---|
| 数值/类别混合的表格分类 | 逻辑回归、随机森林、梯度提升树 |
| 表格回归 | 线性回归、Random Forest、Gradient Boosting |
| 高维稀疏文本 | 逻辑回归、线性 SVM、朴素贝叶斯 |
| 小数据、距离有意义 | KNN、SVM |
| 需要强可解释性 | 线性模型、浅层决策树 |
先从简单且可解释的模型开始。复杂模型只有在相同验证方案下稳定超过基线,才算真正带来收益。
无监督学习
聚类
| 方法 | 核心假设 | 适合数据 | 局限 |
|---|---|---|---|
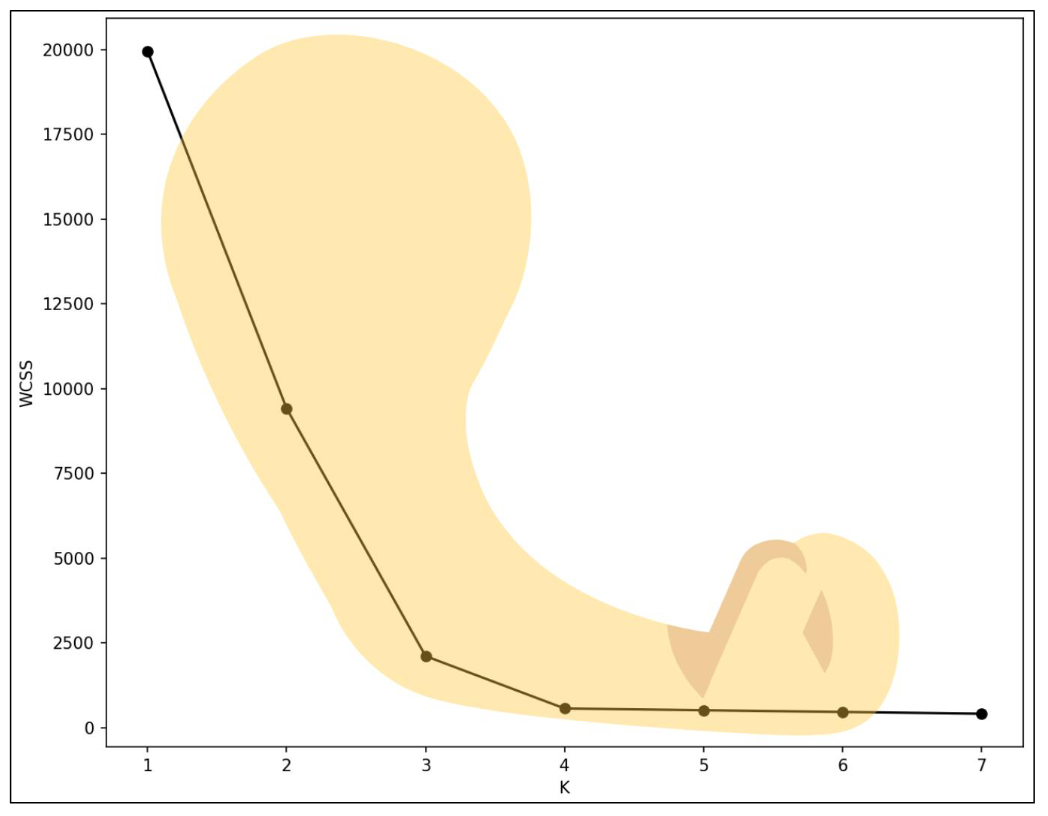
| K-Means | 簇接近球形,以均值为中心 | 数值特征、簇规模相近 | 需指定 K,对尺度和异常值敏感 |
| 层次聚类 | 样本之间存在层级关系 | 中小数据、需要树状结构 | 大数据计算成本高 |
| DBSCAN | 高密度区域形成簇 | 不规则形状、含噪声 | 不同密度下参数难统一 |
| GMM | 数据来自多个高斯分布 | 需要软聚类概率 | 对分布假设和初始化敏感 |
聚类没有标签时,可使用轮廓系数、Calinski-Harabasz 指数等内部指标,但最终仍要验证聚类是否形成稳定、可解释且可行动的业务分组。
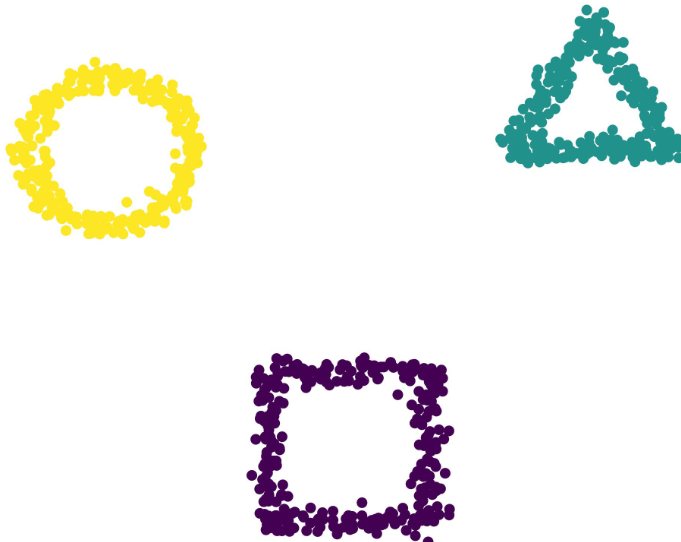
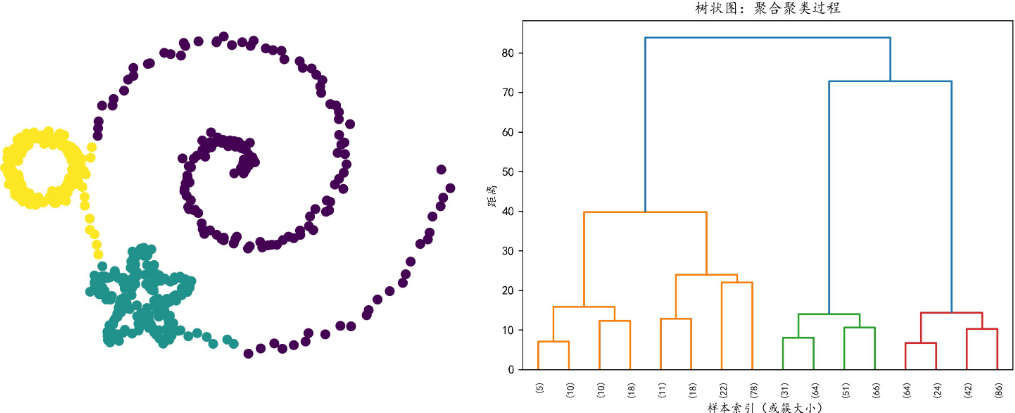
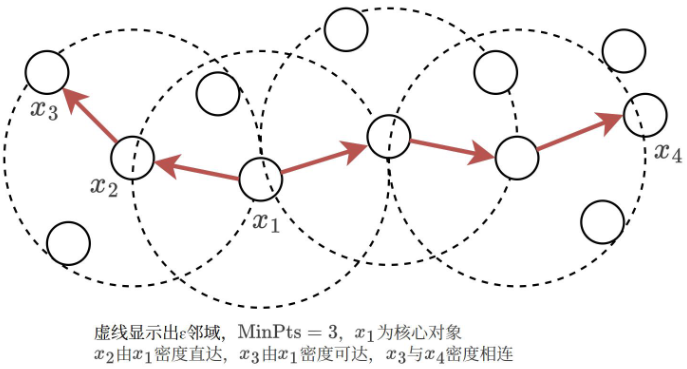
选择 K-Means 的簇数时,可以把肘部法作为参考,但还要结合稳定性、轮廓系数和业务可解释性判断。
距离度量
欧氏距离:
$$
d(x,y)=\sqrt{\sum_{i=1}^{n}(x_i-y_i)^2}
$$
曼哈顿距离:
$$
d(x,y)=\sum_{i=1}^{n}|x_i-y_i|
$$
余弦相似度关注方向而不是绝对长度,常用于文本向量:
$$
\cos(x,y)=\frac{x^Ty}{|x||y|}
$$
距离模型必须先处理特征尺度,否则量纲较大的特征会主导结果。
降维
- PCA:线性降维,保留最大方差方向。
- t-SNE:强调局部邻域,适合可视化,不适合直接解释全局距离。
- UMAP:兼顾局部结构和计算效率,常用于二维可视化。
降维图适合探索数据,不能单凭“图上看起来分开”就证明类别天然可分。
正则化与泛化
L1 正则化:
$$
\mathcal{L}_{total}=\mathcal{L}+\lambda\sum_j|w_j|
$$
L2 正则化:
$$
\mathcal{L}_{total}=\mathcal{L}+\lambda\sum_jw_j^2
$$
- L1 容易产生稀疏参数,可用于特征选择。
- L2 平滑地限制参数规模,通常更稳定。
- Elastic Net 同时包含 L1 和 L2。
正则化强度 $\lambda$ 太小无法抑制过拟合,太大则会导致欠拟合,需要通过交叉验证选择。
一套可靠的建模清单
训练前
- 明确预测时刻、标签定义和错误成本。
- 检查重复样本、标签质量和时间穿越。
- 按实体或时间选择正确的数据划分方式。
- 建立最简单的规则或线性基线。
训练中
- 将预处理放入 Pipeline 和交叉验证。
- 同时记录训练与验证指标。
- 固定随机种子并保存数据版本、特征版本和代码版本。
- 进行误差分析,而不只比较排行榜上的单个分数。
上线前后
- 在独立测试集上做最终评估。
- 检查关键人群、时间段和长尾样本表现。
- 确认离线预处理与在线特征完全一致。
- 监控输入漂移、预测分布、业务指标和反馈标签延迟。
